SEO und Sichtbarkeit · SEO und Sichtbarkeit
Technisches SEO: Die wichtigsten Grundlagen
Eine hilfreiche Website kann ihre Aufgabe nur erfüllen, wenn Menschen und Suchmaschinen auf ihre Inhalte zugreifen können. Technisches SEO schafft dafür die Voraussetzungen: Seiten müssen zuverlässig antworten, wichtige Inhalte verständlich ausliefern und eindeutige Signale zu ihrer Verarbeitung senden. Das ist keine Sammlung geheimer Einstellungen, sondern sorgfältige Arbeit am bestehenden Webauftritt.
Dieser Leitfaden erklärt die wichtigsten Zusammenhänge und zeigt, welche Fehler zuerst Aufmerksamkeit verdienen. Sie müssen nicht jeden technischen Begriff selbst umsetzen können. Entscheidend ist, dass Sie Auffälligkeiten einordnen, die richtigen Fragen stellen und Korrekturen nachvollziehbar kontrollieren können. Gute Technik erleichtert den Zugang, garantiert aber weder Indexierung noch gute Positionen.
Vom Seitenaufruf bis zum möglichen Suchergebnis
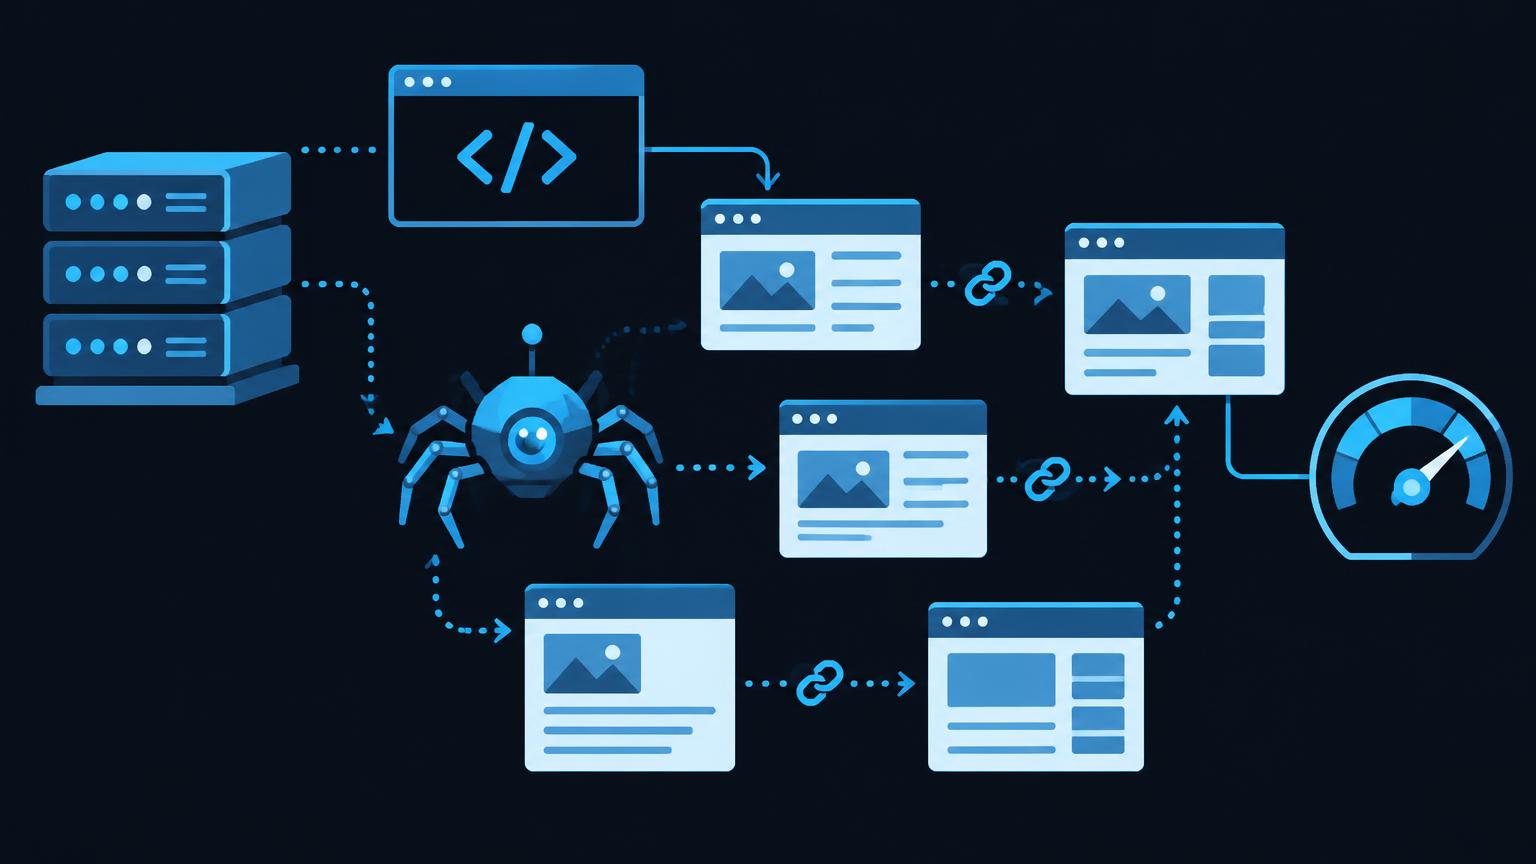
Wenn ein Browser oder ein Crawler eine Adresse aufruft, antwortet der Server mit einem Statuscode und gegebenenfalls mit Inhalten. Ein Crawler ist ein automatisiertes Programm, das erreichbare Seiten abruft. Beim anschliessenden Rendering können zusätzliche Ressourcen und JavaScript nötig sein, damit der sichtbare Inhalt entsteht. Diese Schritte sollten Sie getrennt betrachten.
Indexierung bedeutet, dass ein Suchsystem die verarbeiteten Inhalte in seinen Index aufnimmt. Erst daraus können passende Suchergebnisse entstehen. Die Grafik zeigt diesen Weg bewusst ohne Erfolgsgarantie. Ein erfolgreicher Abruf ist eine wichtige Voraussetzung, aber noch kein Nachweis dafür, dass eine Seite tatsächlich indexiert wird oder für eine bestimmte Anfrage erscheint.
Prüfen Sie bei Problemen deshalb zuerst den Ort der Unterbrechung. Antwortet der Server nicht? Fehlt der Text nach dem Rendering? Ist die Indexierung ausgeschlossen? Oder ist die Seite technisch erreichbar, beantwortet aber die Suchabsicht nicht? Die allgemeinen SEO Grundlagen helfen, technische und inhaltliche Ursachen auseinanderzuhalten.
robots.txt und noindex haben verschiedene Aufgaben
Die Datei robots.txt liegt im Stammverzeichnis eines Hosts und steuert, welche Bereiche bestimmte Crawler abrufen dürfen. Sie ist keine Zugangssicherung und kein zuverlässiges Werkzeug, um eine Adresse aus Suchergebnissen zu entfernen. Laut Googles Einführung zu robots.txt kann eine gesperrte Adresse unter Umständen trotzdem als Adresse in Suchergebnissen erscheinen.
Die Anweisung noindex fordert unterstützende Suchmaschinen dagegen auf, eine Seite nicht zu indexieren. Sie kann beispielsweise als Metaanweisung im HTML oder als HTTP Header ausgeliefert werden. Damit Google sie erkennen kann, muss die betreffende Seite abrufbar sein. Eine gleichzeitige Crawling Sperre kann daher verhindern, dass Google die Anweisung überhaupt sieht.
Für private Inhalte benötigen Sie einen echten Zugriffsschutz, etwa eine Anmeldung. Weder noindex noch robots.txt ersetzen diesen Schutz. Kontrollieren Sie nach einem Relaunch besonders sorgfältig, ob auf öffentlichen Leistungsseiten versehentlich Sperren aus der Testumgebung verblieben sind. Umgekehrt dürfen private Vorschauen nicht allein auf die freiwillige Beachtung durch Suchmaschinen vertrauen.
Canonical und XML Sitemap: Adressen verständlich ordnen
Derselbe Inhalt kann unter mehreren Adressen erreichbar sein, beispielsweise durch Parameter oder unterschiedliche URL Varianten. Ein Canonical signalisiert, welche Adresse Sie als bevorzugte Version betrachten. Es ist kein Befehl, den Google zwingend übernehmen muss. Widersprüchliche Signale erschweren die Zuordnung, etwa wenn interne Links auf eine andere Version zeigen als das Canonical.
Google beschreibt die Verfahren in der Dokumentation zur Angabe kanonischer URLs. Legen Sie pro wichtigem Inhalt eine nachvollziehbare Hauptadresse fest. Prüfen Sie insbesondere, ob Vorlagen versehentlich alle Unterseiten auf die Startseite verweisen. Ein solches Muster kann fachlich unterschiedliche Inhalte falsch zusammenführen.
Eine XML Sitemap listet wichtige Adressen in einem maschinenlesbaren Format. Sie erleichtert die Entdeckung, garantiert aber keine Indexierung. Nehmen Sie dafür vorgesehene öffentliche Hauptversionen auf und entfernen Sie gelöschte oder bewusst ausgeschlossene Adressen. Die Sitemap ersetzt weder eine verständliche Navigation noch intern verlinkte Leistungsseiten. Inhalt, Verlinkung und technische Angaben sollten zusammenpassen.
Statuscodes, Weiterleitungen und fehlerhafte Seiten
Ein Statuscode beschreibt die Antwort des Servers. 200 steht üblicherweise für einen erfolgreichen Abruf. 404 bedeutet, dass die angefragte Ressource nicht gefunden wurde, und 410 kennzeichnet eine nicht mehr verfügbare Ressource. Fehler im Bereich 500 weisen auf Probleme auf der Serverseite hin. Entscheidend ist die tatsächliche Antwort, nicht nur die sichtbare Gestaltung.
Eine dauerhafte Weiterleitung kann mit 301 oder 308 umgesetzt werden. Für vorübergehende Situationen kommen andere Codes wie 302 oder 307 infrage. Wählen Sie das Verhalten passend zum tatsächlichen Vorgang. Bei einem Seitenumzug sollte eine alte Adresse möglichst direkt zum fachlich entsprechenden neuen Inhalt führen und nicht über mehrere Zwischenstationen.
Nicht jede entfernte Seite benötigt eine Weiterleitung. Gibt es keinen passenden Ersatz, kann eine korrekte Fehlerantwort sinnvoll sein. Eine hübsche Fehlerseite mit Status 200 kann dagegen zu einem sogenannten Soft 404 führen. Leiten Sie deshalb nicht pauschal jede unbekannte Adresse auf die Startseite um. Prüfen Sie ausserdem interne Verweise, damit Besucher möglichst nicht erst auf veralteten Adressen landen.
Mobile Darstellung, HTTPS und verständliche URLs
Wichtige Inhalte müssen auch auf kleinen Bildschirmen nutzbar bleiben. Prüfen Sie Navigation, Formulare, Tabellen und Kontaktmöglichkeiten ebenso wie den Fliesstext. Eine mobile Darstellung ist nicht allein deshalb gut, weil sie optisch schmaler wird. Fehlende Texte oder verdeckte Bedienelemente können die Nutzung erheblich erschweren. Der Beitrag zum responsiven Webdesign ergänzt diese Prüfung.
HTTPS schützt die Übertragung zwischen Browser und Server durch Verschlüsselung. Es ersetzt weder sichere Passwörter noch die Absicherung des Systems. Achten Sie auf ein gültiges Zertifikat und darauf, dass wichtige Ressourcen nicht über unsichere Verbindungen nachgeladen werden. Wenn Sie Varianten vereinheitlichen, müssen Weiterleitungen, interne Links und bevorzugte Adressen konsistent sein.
Eine verständliche URL Struktur hilft bei Pflege und Orientierung. Wählen Sie stabile, aussagekräftige Pfade und vermeiden Sie unnötige Varianten für denselben Inhalt. Ändern Sie bestehende Adressen nicht allein wegen eines vermeintlich schöneren Erscheinungsbilds. Jede Umstellung benötigt eine Planung für Weiterleitungen und Verweise. Interne Links sollten direkt auf erreichbare Zielseiten führen und ihren Inhalt nachvollziehbar benennen.
Ladegeschwindigkeit und Core Web Vitals richtig lesen
Lange Wartezeiten können Besucher behindern, besonders bei mobilen Verbindungen. Prüfen Sie deshalb grosse Bilder, unnötige Skripte, blockierende Ressourcen und die Antwortzeit des Servers. Ein einzelner Messwert sagt jedoch nicht, wie sich jede reale Nutzung anfühlt. Gerät, Verbindung, Cache und Seitenzustand können das Ergebnis verändern. Wiederholbare Prüfbedingungen helfen, Verbesserungen sachlich zu bewerten.
Die Core Web Vitals auf web.dev beschreiben drei wichtige Aspekte: Largest Contentful Paint misst den Zeitpunkt des grössten sichtbaren Inhaltselements, Interaction to Next Paint die Reaktionsfähigkeit auf Interaktionen und Cumulative Layout Shift unerwartete Layoutverschiebungen. Die Kennzahlen beantworten unterschiedliche Fragen und sollten nicht zu einer pauschalen Qualitätsnote verkürzt werden.
Als gute Werte gelten LCP bis 2,5 Sekunden, INP bis 200 Millisekunden und CLS bis 0,1. Für die Bewertung realer Nutzungsdaten ist das 75. Perzentil massgeblich. Laborwerte aus einem Test und Felddaten echter Besuche sind unterschiedliche Perspektiven. Wenn für eine Seite nicht genügend Felddaten vorliegen, ist das kein Nachweis für gute oder schlechte Nutzung.
Leiten Sie aus einem Befund eine konkrete Aufgabe ab: Bildabmessungen reservieren, unnötige Skripte reduzieren oder das wichtigste Bild passend ausliefern. Vor der Umsetzung ist zu prüfen, welche Ressourcen tatsächlich benötigt werden. Entfernen Sie nicht unbesehen Funktionen, nur um einen Testwert zu verbessern. Gute Messwerte garantieren keine gute Suchposition.
Fragen Sie eine technische Website Analyse an, um wichtige Hindernisse und passende nächste Schritte einzuordnen.
Unverbindlich anfragenJavaScript und strukturierte Daten nachvollziehbar prüfen
Moderne Websites erzeugen Inhalte teilweise mit JavaScript. Das ist nicht grundsätzlich problematisch, verlangt aber Kontrolle. Ein sichtbarer Browserinhalt kann fehlen, wenn erforderliche Skripte oder Schnittstellen nicht erreichbar sind. Prüfen Sie deshalb, ob die wichtigen Texte und Links in der verarbeiteten Ansicht vorhanden sind und ob Fehler das Laden verhindern.
Wichtige interne Links sollten als echte Links mit nachvollziehbarem Ziel umgesetzt sein. Eine Schaltfläche, die nur eine lokale Aktion ausführt, ersetzt nicht automatisch einen gut auffindbaren Seitenverweis. Vermeiden Sie zudem, zentrale Leistungsinformationen erst nach schwer nachvollziehbaren Interaktionen zugänglich zu machen. Menschen und Suchsysteme benötigen einen klaren Weg zu den relevanten Inhalten.
Strukturierte Daten beschreiben Inhalte in einem standardisierten Format. Die Angaben müssen zum sichtbaren Inhalt passen und sachlich korrekt sein. Fehlerfreie Auszeichnung allein garantiert keine besondere Suchdarstellung. Ob ein bestimmter Typ unterstützt wird und für Ihren Inhalt geeignet ist, ist vor der Umsetzung zu prüfen. Der Artikel zu strukturierten Daten erklärt diese Abgrenzung ausführlicher.
Eine technische Bestandsaufnahme mit klaren Fragen
Beginnen Sie mit repräsentativen Seiten: Startseite, wichtige Leistungen, ein Ratgeber und eine Kontaktseite. Bei umfangreichen Websites ergänzen Sie unterschiedliche Vorlagen. So erkennen Sie eher, ob ein Fehler nur eine Adresse betrifft oder systematisch in einer gemeinsamen Vorlage steckt. Die reine Anzahl gefundener Meldungen sagt noch nichts über die geschäftliche Bedeutung aus.
| Technischer Bereich | Mögliche Auffälligkeit | Auswirkung | Prüfwerkzeug |
|---|---|---|---|
| Indexierung | Unbeabsichtigtes noindex | Seite soll nicht im Index erscheinen | URL Prüfung und Quelltext |
| Serverantwort | Fehler oder Weiterleitungskette | Abruf erschwert oder unterbrochen | Browser Netzwerkansicht |
| Canonical | Verweis auf unpassende Hauptadresse | Widersprüchliche Zuordnung | Quelltext und URL Prüfung |
| Mobile Nutzung | Verdeckte Navigation | Wichtige Bereiche schlecht erreichbar | Browser mit schmaler Ansicht |
| Ladeverhalten | Späte Inhalte oder Layoutsprünge | Nutzung wird erschwert | PageSpeed Insights |
| JavaScript | Leistungstext fehlt nach Verarbeitung | Zentrale Information nicht verfügbar | Gerenderte Ansicht und Konsole |
Ergänzen Sie zu jedem Befund die betroffenen Adressen, das erwartete Verhalten und einen überprüfbaren Nachweis. Damit kann eine Fachperson gezielt arbeiten, statt eine allgemeine Fehlerliste interpretieren zu müssen. Die Website Analyse ordnet solche Befunde ein; eine anschliessende Website Verbesserung sollte konkrete Aufgaben und Nachkontrollen enthalten.
Interaktives Beispiel: Prüfpunkte verständlich öffnen
In der technischen Beispielprüfung öffnen Sie neutrale Prüfpunkte zu Erreichbarkeit, Indexierung, Weiterleitungen und Darstellung. Jeder Punkt erklärt, was eine Auffälligkeit bedeuten kann und welche nächste Kontrolle sinnvoll ist. Die Reihenfolge soll Ihnen helfen, grundlegende Hindernisse vor kosmetischen Verbesserungen zu erkennen.
Diese Demo scannt keine echte Website. Sie prüft keine Domain, ruft keine Serverantworten ab und stellt kein tatsächliches Prüfergebnis aus. Die Beispiele dienen dem Verständnis. Wenn Sie dieselben Fragen für Ihren eigenen Auftritt beantworten möchten, benötigen Sie Zugriff auf die Website und geeignete Messdaten.
Priorisieren, beheben und mit Search Console nachkontrollieren
Priorisieren Sie zuerst Fehler, die wichtige Inhalte vollständig blockieren oder öffentliche Seiten fälschlich ausschliessen. Danach folgen falsche Zuordnungen, problematische Weiterleitungen und zentrale Nutzungsprobleme. Eine kleine Auffälligkeit auf einer unwichtigen Altseite hat eine andere Bedeutung als derselbe Fehler in allen Leistungsseiten. Berücksichtigen Sie Reichweite, Geschäftsrelevanz und Aufwand gemeinsam.
Die Search Console unterstützt die Nachkontrolle mit Berichten zur Indexierung und der Prüfung einzelner URLs. Berichte können zeitversetzt reagieren. Vergleichen Sie daher die aktuelle technische Antwort mit den gespeicherten Informationen und dokumentieren Sie den Zeitpunkt der Korrektur. Eine erfolgreiche Liveprüfung ersetzt nicht die Feststellung, welche Version bereits verarbeitet wurde.
Checkliste für die technische Freigabe
- Wichtige öffentliche Seiten antworten mit dem vorgesehenen Statuscode.
- Private Inhalte sind durch echten Zugriffsschutz gesichert.
- robots.txt und noindex widersprechen dem vorgesehenen Zweck nicht.
- Canonical, Sitemap und interne Links zeigen konsistente Hauptadressen.
- Weiterleitungen führen direkt zu passenden Inhalten.
- Mobile Navigation und Formulare bleiben nutzbar.
- Wichtige Texte und Links sind nach der Verarbeitung vorhanden.
- Ladeprobleme werden mit passenden Laborwerten und verfügbaren Felddaten eingeordnet.
- Korrekturen und Nachkontrollen sind pro Befund dokumentiert.
Technisches SEO bleibt eine wiederkehrende Aufgabe, besonders nach Erweiterungen oder einem Relaunch. Gleichzeitig ersetzt ein sauberer technischer Zustand keine hilfreichen Inhalte. Für eine begründete Priorisierung können Sie eine technische Website Analyse anfragen. Die wichtigsten Zusammenhänge finden Sie auch am Artikelanfang.
Zusammenfassung
- Crawling, Rendering und Indexierung sind unterschiedliche Schritte.
- robots.txt steuert Abrufe; noindex ersetzt keinen Zugriffsschutz.
- Canonical, Sitemap und interne Links sollten zusammenpassen.
- Statuscodes und Weiterleitungen müssen den tatsächlichen Inhalt abbilden.
- Mobile Nutzung und Ladeverhalten gehören zur technischen Qualitätsprüfung.
- Gute Technik garantiert keine Indexierung oder guten Positionen.
Häufige Fragen
Verhindert robots.txt sicher die Indexierung?
Nein, robots.txt steuert in erster Linie das Crawling. Eine gesperrte Adresse kann unter Umständen trotzdem in Suchergebnissen erscheinen. Für private Inhalte brauchen Sie einen echten Zugriffsschutz.
Warum kann noindex trotz korrekter Schreibweise unwirksam bleiben?
Google muss die Anweisung abrufen können. Verhindert eine Crawling Sperre den Zugriff, kann die Anweisung unerkannt bleiben. Kontrollieren Sie deshalb das Zusammenspiel der Einstellungen.
Ist ein Canonical eine verbindliche Anweisung?
Nein, es signalisiert die bevorzugte Version eines Inhalts. Google kann eine andere Adresse auswählen. Konsistente interne Links und weitere passende Signale helfen bei einer eindeutigen Zuordnung.
Muss jede gelöschte Seite weitergeleitet werden?
Nein, ohne passenden Ersatz kann eine korrekte Antwort mit 404 oder 410 sinnvoll sein. Gibt es einen fachlich entsprechenden neuen Inhalt, ist eine passende Weiterleitung zu prüfen. Eine pauschale Weiterleitung aller Fehler auf die Startseite ist keine saubere Lösung.
Garantieren gute Core Web Vitals bessere Rankings?
Nein, gute Messwerte sind keine Garantie für Positionen. Sie helfen, bestimmte Aspekte der Nutzererfahrung zu beurteilen. Relevante und hilfreiche Inhalte bleiben ebenfalls notwendig.
Ist JavaScript für SEO grundsätzlich ungeeignet?
Nein, entscheidend ist die zuverlässige Verarbeitung. Wichtige Inhalte und Links müssen erreichbar sein und nach dem Rendering korrekt vorliegen. Fehler in Skripten oder benötigten Ressourcen sollten Sie gezielt prüfen.
Quellen
- Startleitfaden zur Suchmaschinenoptimierung (SEO): Grundlagen | Google Search Central | Documentation | Google for DevelopersGoogle · geprüft am 05.11.2026
- Einführung und Leitfaden zu robots.txt-Dateien | Google Search Central | Documentation | Google for DevelopersGoogle · geprüft am 05.11.2026
- Kanonische URL mit rel="canonical" und anderen Methoden angeben | Google Search Central | Documentation | Google for DevelopersGoogle · geprüft am 05.11.2026
- Web Vitals | Articles | web.devGoogle / web.dev · geprüft am 05.11.2026